Datos de voz · Español latinoamericano
Voces diversas,
consentidas y listas
para entrenar IA.
Grabaciones con acentos caribeños, andinos y rioplatenses, organizadas con consentimiento documentado, audio cuidado y metadatos útiles.
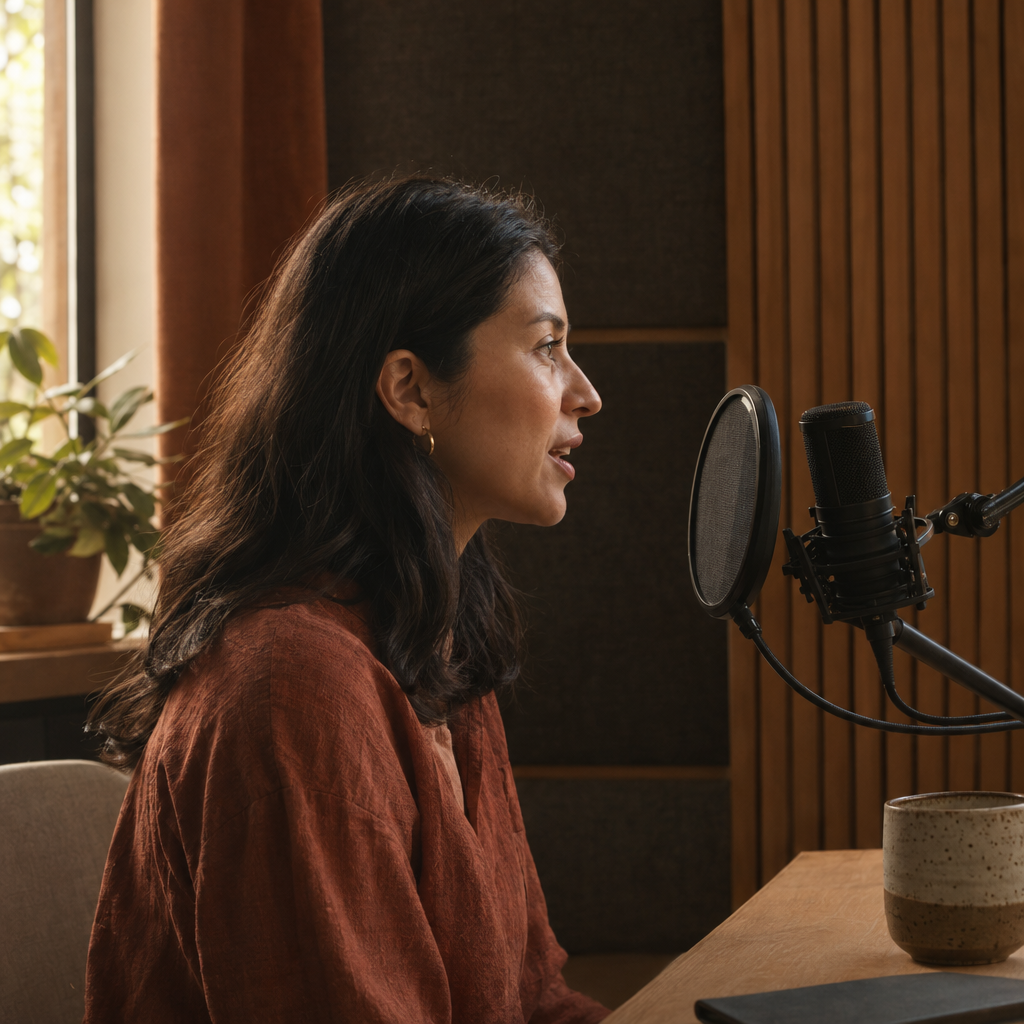
01 / Cobertura
El español tiene muchos ritmos.
Ponemos el foco en variedades regionales que aportan contexto a los datos de voz para inteligencia artificial.
- 01
Caribeño
Variedad en foco - 02
Andino
Variedad en foco - 03
Rioplatense
Variedad en foco
02 / Qué acompaña cada conjunto
La voz importa. Su contexto también.
Datos organizados para que los equipos puedan evaluar su origen, su calidad y las condiciones bajo las que pueden trabajar con ellos.
- 01
Consentimiento documentado
La participación y las condiciones de uso quedan registradas.
- 02
Audio cuidado
Grabaciones organizadas con atención a su calidad técnica.
- 03
Metadatos útiles
Contexto claro para evaluar y trabajar con cada conjunto.
- 04
Licencias claras
Condiciones descritas para facilitar su evaluación y uso.
03 / Así trabajamos
Claridad desde la primera conversación.
Cada proyecto tiene necesidades distintas. Empezamos por entenderlas y acordar el alcance del material y de su licencia.
Cuéntanos qué necesitas- 01
Definimos la cobertura
Alineamos las variedades de español y las necesidades de datos de tu proyecto.
- 02
Ordenamos el material
Reunimos grabaciones, consentimiento y metadatos en torno a cada conjunto.
- 03
Acordamos la licencia
Revisamos el alcance y las condiciones antes de avanzar con el uso del material.
Para equipos que construyen con voz
Hablemos de datos de voz para IA.
Cuéntanos qué está explorando tu equipo. Puedes escribirnos con una consulta general sobre datos de voz para inteligencia artificial.